US-Verlage klagen gegen Brave
Die New York Times hat am 2. November 2026 vor einem Bundesgericht in Manhattan Klage gegen Brave eingereicht. Der Anbieter des datenschutzorientierten Browsers soll urheberrechtlich geschützte Inhalte erfasst und an KI-Unternehmen vertrieben haben.
Am selben Tag reichten Daily News, Chicago Tribune und Orlando Sentinel eine separate Klage bei demselben Gericht ein. Bei sämtlichen Vorwürfen handelt es sich bislang um die Darstellung der Kläger. Eine öffentliche Erwiderung von Brave lag zunächst nicht vor.
Index soll mehr als 30 Milliarden Webseiten umfassen
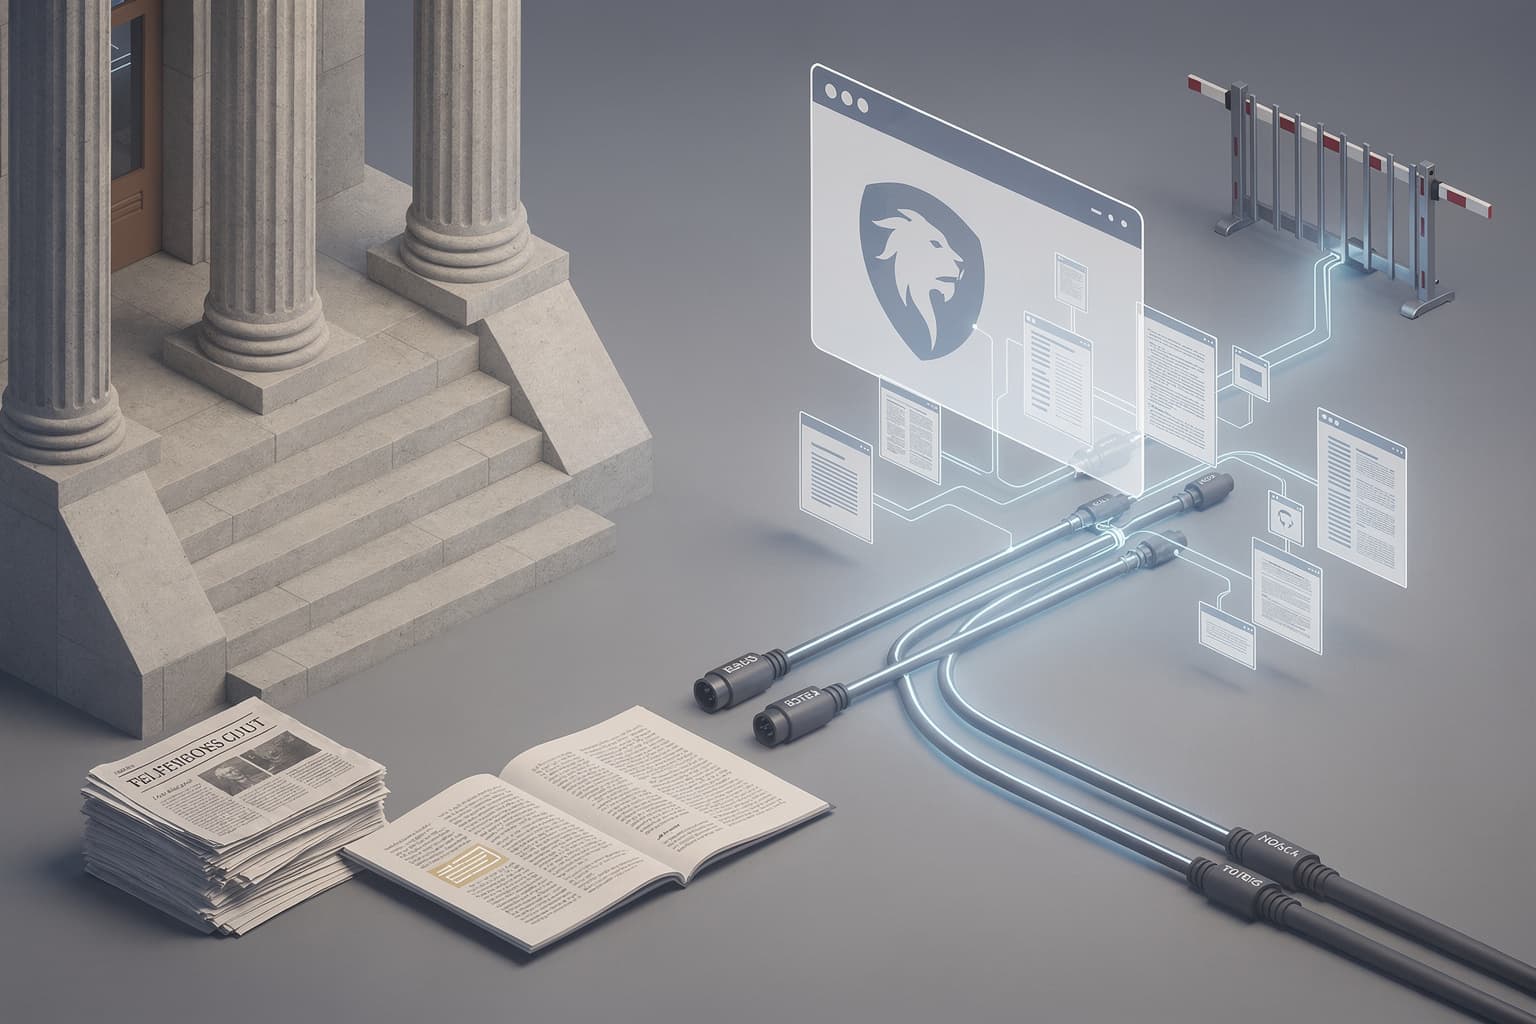
Laut Klageschrift baute Brave mit einem nicht identifizierbaren Web-Crawler einen Index aus mehr als 30 Milliarden Webseiten auf. Ein Web-Crawler ist ein automatisiertes Programm, das Internetseiten aufruft und deren Inhalte für Suchmaschinen oder Datendienste erfasst.
Die Verlage argumentieren, dass sie den Crawler wegen seiner fehlenden eindeutigen Identifikation nicht gezielt blockieren konnten. Als Abnehmer der Daten nennt die Klage Anthropic, Perplexity, Mistral, xAI und Cohere. Ob diese Unternehmen selbst in das Verfahren einbezogen werden, bleibt offen.
| Kennzahl | Angabe |
|---|---|
| Umfang des beanstandeten Index | Mehr als 30 Milliarden Webseiten |
| Gründungsjahr von Brave | 2015 |
| Bisher eingeworbenes Risikokapital | Rund 250 Millionen US-Dollar |
| Einreichung der Klagen | 2. November 2026 |
Der Streit reiht sich in die wachsende Auseinandersetzung um automatisierte Datenerfassung ein. Webseitenbetreiber reagieren zunehmend mit technischen Sperren und Zugangskontrollen, wie auch die geplante Login-Pflicht von Reddit gegen KI-Scraping zeigt. Gleichzeitig unterstützt OpenAI inzwischen ein robots.txt-Signal für KI-Training, das Webseitenbetreibern mehr Kontrolle geben soll.
Paywalls und Werbegeschäft ebenfalls betroffen
Die Klage beschränkt sich nicht auf den Aufbau des Webindex. Sie richtet sich außerdem gegen eine Browser-Funktion, mit der sich nach Darstellung der Kläger Paywalls umgehen lassen. Hinzu kommt der Vorwurf, Brave blockiere Anzeigen der Verlage und verkaufe gleichzeitig eigene Werbung.
Sinngemäß bezeichnet die New York Times Brave in der Klageschrift zugleich als Einbrecher, der sich Verlagsinhalte aneigne, und als Hehler, der diese Inhalte an Dritte weiterverkaufe.
Die Formulierung verdeutlicht die Stoßrichtung des Verfahrens, ersetzt aber keine gerichtliche Feststellung. Die New York Times verlangt eine Unterlassungsverfügung und Schadensersatz. Eine konkrete Höhe der Forderung wurde nicht genannt.
Die Zeitung führt bereits ähnliche Verfahren gegen OpenAI und Perplexity. Auch andere Plattformbetreiber geraten wegen ihrer Regeln zur Datennutzung unter Druck. So hatte Meta eine Klausel zum Website-Scraping gestrichen, nachdem deren Reichweite Fragen zur Nutzung fremder Inhalte aufgeworfen hatte.
Risiko für KI-Datenlieferketten
Für Unternehmen im DACH-Raum ist weniger der konkrete US-Prozess entscheidend als die Struktur dahinter. KI-Anbieter beziehen Daten häufig über externe Indizes, Suchdienste und spezialisierte Datenlieferanten. Sind Herkunft und Nutzungsrechte dieser Daten unklar, entsteht ein rechtliches Risiko entlang der gesamten Lieferkette.
Das gilt auch für europäische Anbieter. Das französische Unternehmen Mistral wird in der Klage als Empfänger von Brave-Daten genannt. Daraus folgt noch keine eigene Rechtsverletzung, wohl aber die Notwendigkeit, Datenquellen und Vertragszusicherungen genauer zu prüfen.
Der Fall zeigt zudem, dass ein datenschutzorientiertes Endprodukt nicht automatisch eine rechtssichere Datenbeschaffung garantiert. Datenschutz, Urheberrecht und technische Transparenz sind getrennte Prüffelder. Ein Browser kann beim Schutz persönlicher Daten Vorteile bieten und dennoch wegen anderer Geschäftspraktiken rechtlich angreifbar sein.
Eigene KI-Systeme brauchen nachvollziehbare Daten
Für selbst betriebene KI-Lösungen und interne Wissenssysteme spricht der Streit für klar dokumentierte Datengrundlagen. Eigene Unternehmensdaten, ausdrücklich lizenzierte Inhalte und transparente Open-Source-Datensätze lassen sich rechtlich und technisch besser kontrollieren als undurchsichtige Datenpakete externer Anbieter.
Self-Hosting beseitigt Urheberrechtsrisiken allerdings nicht automatisch. Es verlagert die Verantwortung für Auswahl, Lizenzprüfung und Dokumentation zum betreibenden Unternehmen. Dafür sinkt die Abhängigkeit von Datenlieferanten, deren Index oder Geschäftsmodell durch Klagen und Unterlassungsverfügungen kurzfristig eingeschränkt werden könnte.
Bei KI-SaaS sollte daher nicht nur die Modellleistung geprüft werden. Relevant sind auch die Herkunft der verwendeten Daten, vertragliche Freistellungen, Löschprozesse und mögliche Ersatzlieferanten. Der Rechtsstreit um Brave macht sichtbar, dass die Datenbasis eines KI-Dienstes ebenso kritisch sein kann wie das Modell selbst.