Huawei zieht den Ascend 960DT auf Anfang 2027 vor
Huawei hat auf seiner Connect-Konferenz die nächste Generation seiner Ascend-Beschleuniger vorgestellt. Der Ascend 960DT soll bereits im ersten Quartal 2027 erscheinen und damit drei Quartale früher als ursprünglich geplant.
Die Bezeichnung DT steht für Decode und Training. Der Chip erreicht laut Huawei 4 PFLOPS bei FP4 und 2 PFLOPS bei FP8. Diese Zahlen beschreiben die Rechenleistung mit unterschiedlich präzisen Zahlenformaten, wobei FP4 vor allem für besonders rechenintensive KI-Anwendungen eingesetzt wird.
Hinzu kommen bis zu 288 GB proprietärer HiZQ-Speicher. Gegenüber der Ascend-950-Serie sollen sich sowohl die Rechenleistung als auch die Speicherkapazität verdoppeln.
| Beschleuniger | Geplanter Start | FP4-Leistung | Speicher | Aufgabe |
|---|---|---|---|---|
| Ascend 960DT | Q1 2027 | 4 PFLOPS | 288 GB HiZQ | Training und Decode |
| Ascend 960PR | Q3 2027 | 8 PFLOPS | 192 GB HiBL, 2,4 TB/s | Prefill und Empfehlungssysteme |
| Ascend 970-Serie | 2028 | 14 PFLOPS | 288 GB, 14,4 TB/s | Nächste Generation |
| Weitere Generation | 2029 | 28 PFLOPS | 384 GB, 38,4 TB/s | Roadmap |
Geringere Leistung pro Chip, größere Cluster
Bei der Rechendichte pro Chip bleibt Huawei hinter Nvidias Rubin und AMDs MI455X zurück. Diese Spitzenmodelle stehen chinesischen Kunden aufgrund der US-Exportbeschränkungen jedoch nicht regulär zur Verfügung. Gegenüber den für China zugelassenen Nvidia-Modellen positioniert sich der Ascend 960DT deshalb als deutlich leistungsfähigere heimische Alternative.
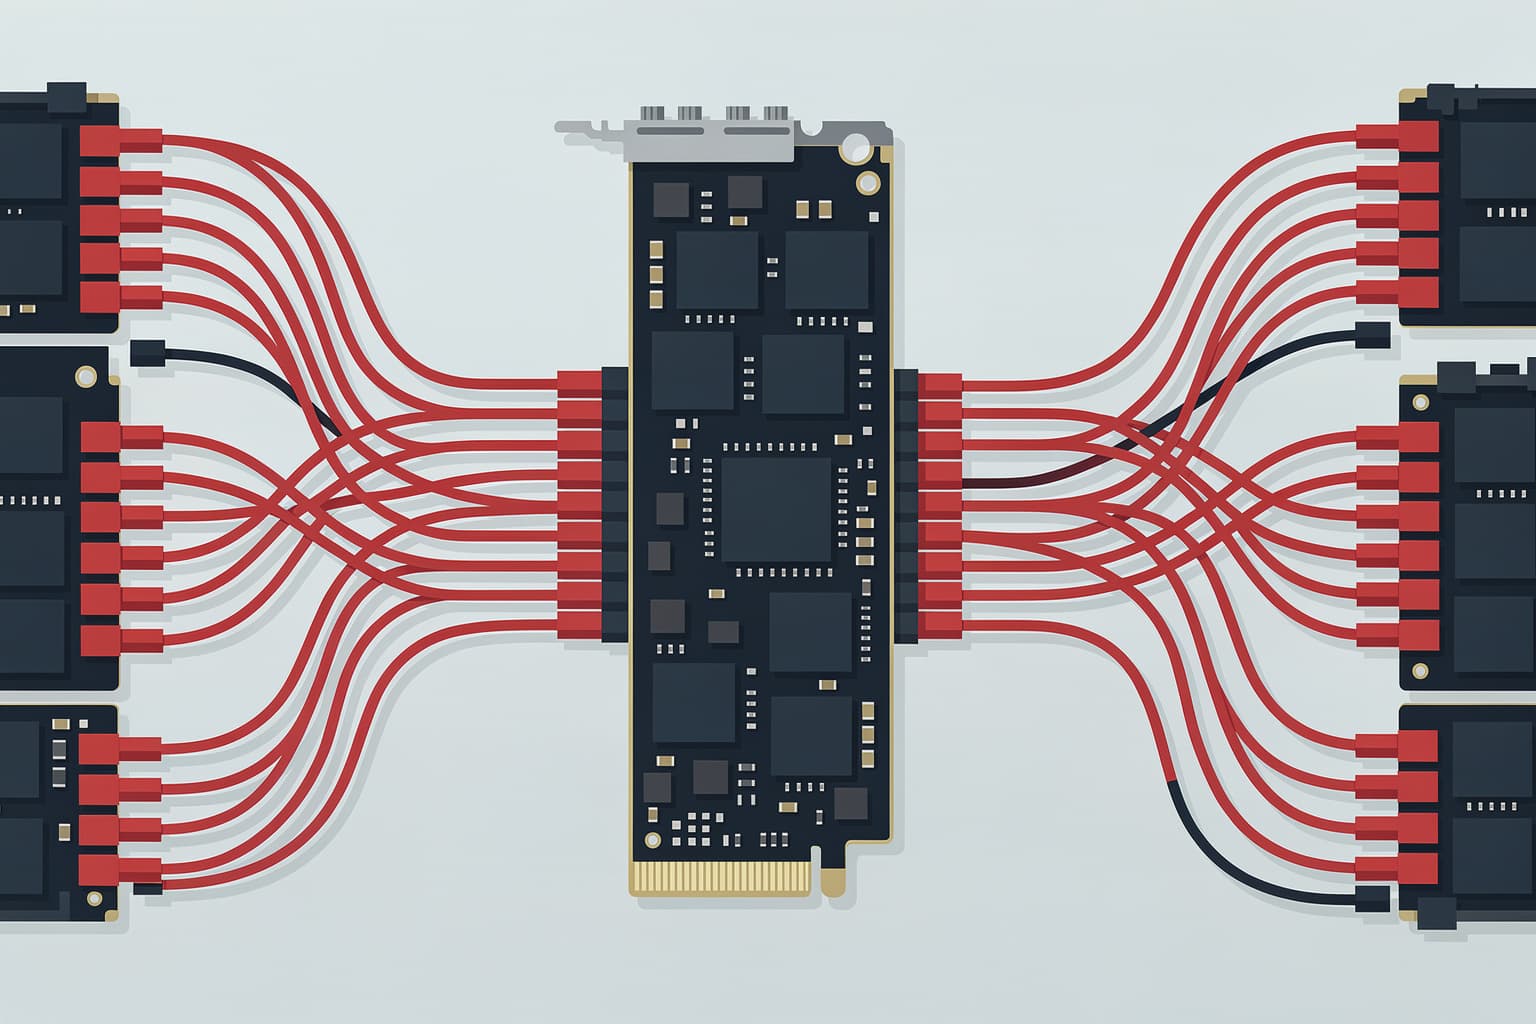
Huawei versucht den Rückstand einzelner Chips zusätzlich über die Größe des Gesamtsystems auszugleichen. Mit Near Packaged Optics, kurz NPO, werden optische Verbindungen nahe am Chipgehäuse integriert. Dadurch sollen Cluster mit bis zu 4.096 Beschleunigern und einer Gesamtleistung von 16 ExaFLOPS bei FP4 möglich werden.
Der strategische Punkt liegt nicht allein in der Leistung eines einzelnen Chips. Entscheidend ist, wie effizient Tausende Beschleuniger verbunden, betrieben und ausgelastet werden können.
Huawei gibt an, 48.000 steckbare optische Module durch 5.500 Hi-One-NPO-Einheiten ersetzen zu können. Das soll den Strombedarf um 550 Kilowatt senken, die Fehlerrate halbieren und eine Verfügbarkeit von 99,8 % ermöglichen. Dabei handelt es sich um Herstellerangaben, deren Übertragbarkeit auf große Produktivsysteme noch nicht unabhängig bestätigt ist.
Getrennte Hardware für Prefill und Decode
Für das dritte Quartal 2027 ist der Ascend 960PR geplant. PR steht für Prefill und Recommenders. Beim Prefill verarbeitet ein Sprachmodell den eingegebenen Prompt, während in der anschließenden Decode-Phase die Ausgabe schrittweise erzeugt wird.
Huawei verteilt diese Aufgaben auf unterschiedliche Chips. Der rechenoptimierte 960PR übernimmt den Prefill, der speicherstärkere 960DT die Decode-Phase. Solche heterogenen Inferenz-Pipelines können die Hardware besser auslasten, erhöhen aber zugleich die Anforderungen an Orchestrierung, Netzwerktechnik und Software.
Die Speicherarchitektur bleibt dabei ein wichtiger Faktor. Auch Modelle wie DeepSeek V4.1 Flash reduzieren gezielt den GPU-Speicherbedarf, weil Speicherkapazität und Bandbreite bei Betriebskosten und Skalierung oft ebenso relevant sind wie die nominelle Rechenleistung.
Software und Fertigung bleiben offene Punkte
Frühere Ascend-Generationen konnten die Erwartungen chinesischer Modellentwickler nicht durchgehend erfüllen. DeepSeek hatte Berichten zufolge Schwierigkeiten beim Training auf Huawei-NPUs und griff zeitweise wieder auf Nvidia-GPUs zurück. Ob Treiber, Frameworks und Entwicklungswerkzeuge diese Probleme mit der 960-Serie dauerhaft lösen, ist bislang nicht bestätigt.
Offen bleibt auch, welche Stückzahlen Huawei trotz der Fertigungsrestriktionen in China liefern kann. Technische Daten und Clusterkonzepte allein sagen wenig darüber aus, wie schnell eine Plattform in realen Rechenzentren verfügbar wird.
Huawei nennt darüber hinaus eine theoretische Skalierung auf 512.000 NPUs über eine zweistufige Clos-Netzwerktopologie. Langfristig werden sogar Systeme mit mehr als einer Million NPUs in Aussicht gestellt. Diese Größenordnungen sind bislang Konzepte und keine nachgewiesenen Produktivcluster.
Warum die Entwicklung für den DACH-Raum relevant ist
Ein direkter Markteintritt der Ascend-960-Serie im DACH-Raum steht nicht im Mittelpunkt der Ankündigung. Die Beschleuniger sind vor allem eine Antwort auf den durch US-Sanktionen begrenzten chinesischen Markt. Dennoch zeigt die Entwicklung, wie Handelsbeschränkungen parallele Hardware- und Software-Ökosysteme jenseits des Nvidia-Angebots entstehen lassen.
Für Unternehmen mit eigener KI-Infrastruktur bleibt Nvidia im Westen vorerst die dominierende Plattform. Gleichzeitig entstehen Alternativen auf mehreren Ebenen. Dazu gehören spezialisierte Rechenzentren, eigene Chipprogramme und lokale Systeme wie AMDs Threadripper Halo für lokale KI.
Mehr Wettbewerb könnte langfristig die Verfügbarkeit von Beschleunigern verbessern und neue Betriebsmodelle für Open-Source-Modelle ermöglichen. Kurzfristig erhöht die Fragmentierung jedoch den Integrationsaufwand. Wer sich für eine alternative Architektur entscheidet, bindet sich nicht nur an Chips, sondern auch an Compiler, Treiber, Frameworks und Netzwerkkomponenten.
Damit verschiebt sich das Lock-in lediglich auf eine andere Ebene. Eigene Infrastruktur kann laufende Cloud- und Abo-Kosten reduzieren sowie mehr Kontrolle über Daten schaffen. Sie lohnt sich aber nur, wenn Software-Reife, Auslastung, Energiebedarf und Personalaufwand gemeinsam betrachtet werden.