Scale AI gerät wegen Outlier unter Datenschutzdruck
Die Datenschutzorganisation noyb hat fünf Beschwerden gegen Scale AI eingereicht. Zuständig sind Datenschutzbehörden in Österreich, Frankreich, Italien und den Niederlanden. Die Organisation wirft dem US-Unternehmen vor, europäische Auftragnehmer auf seiner Plattform Outlier ohne ausreichende Rechtsgrundlage zu überwachen.
Auf Outlier annotieren Auftragnehmer Daten und bewerten KI-generierte Antworten. Diese Arbeit dient dazu, KI-Modelle zu verbessern. Zu den Kunden von Scale AI gehören OpenAI, xAI, Anthropic, Google und die US-Regierung.
Die Beschwerden betreffen damit nicht nur eine einzelne Arbeitsplattform. Sie werfen auch Fragen zur Lieferkette großer KI-Anbieter auf, die Trainings- und Bewertungsaufgaben an spezialisierte Dienstleister auslagern.
Welche Datenerfassung noyb beanstandet
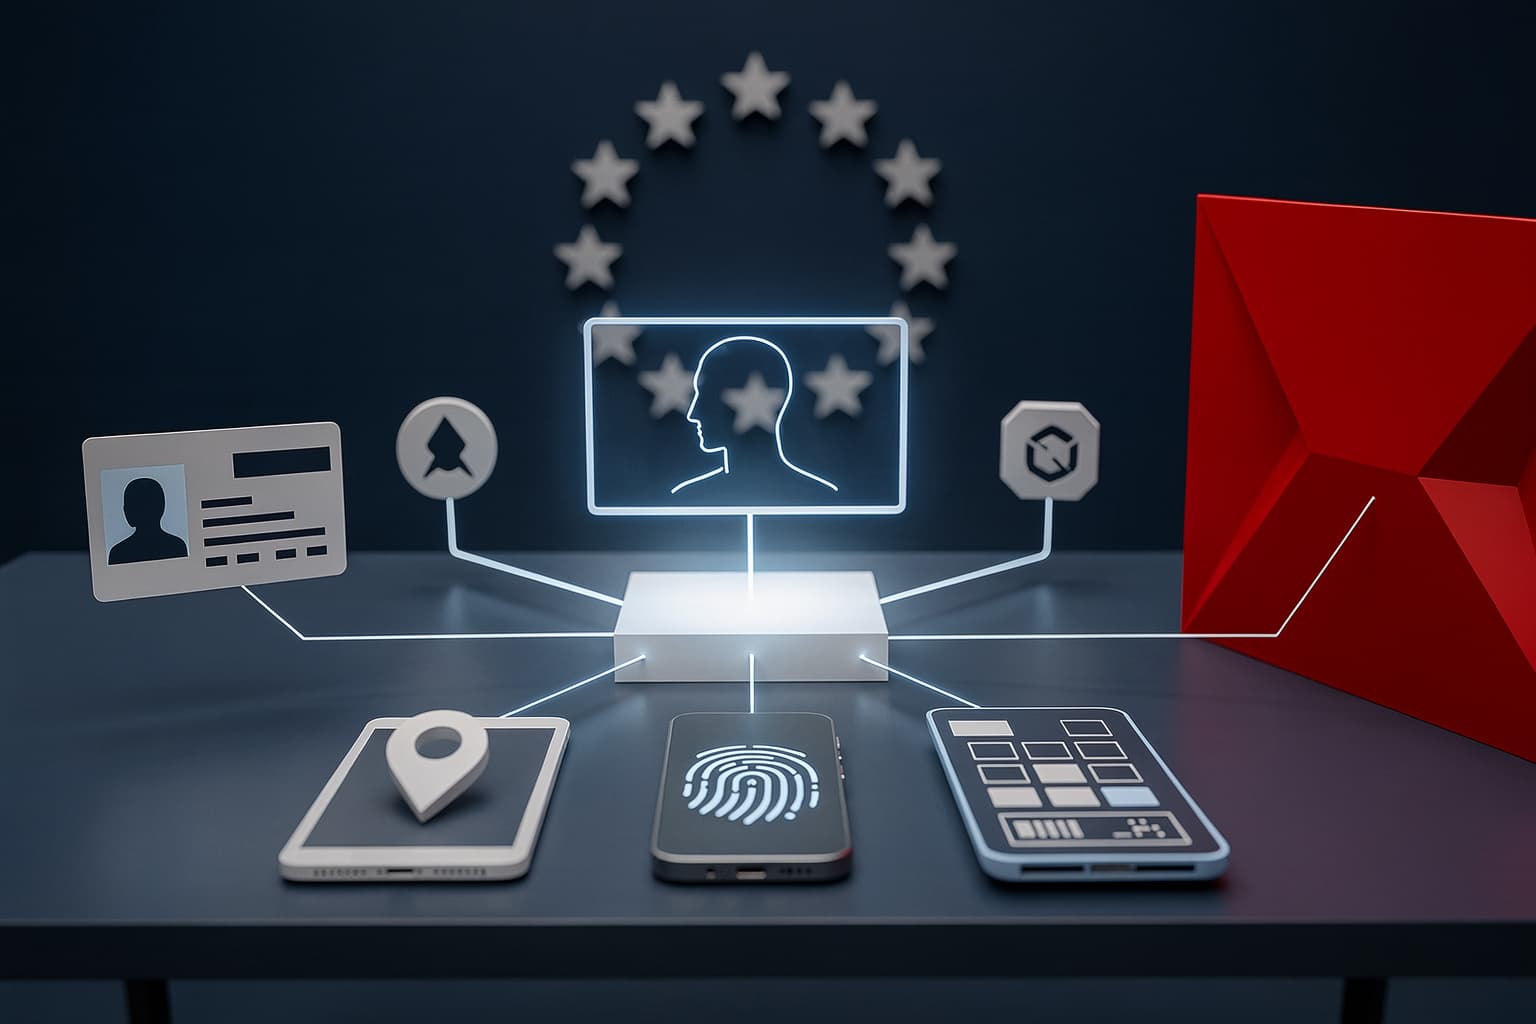
Für die Identitätsprüfung setzt Outlier laut noyb den Dienstleister Persona ein. Dabei sollen biometrische Daten sowie weitere personenbezogene und technische Informationen verarbeitet werden.
| Datenkategorie | Vorwurf von noyb |
|---|---|
| Identitätsdaten | Erfassung biometrischer Merkmale zur Überprüfung von Auftragnehmern |
| Netzwerk und Gerät | Verarbeitung von IP-Adressen, Geräteinformationen und Systemdaten |
| Standort und Adresse | Erfassung von Geodaten und Anschriften |
| Finanzdaten | Verarbeitung von Kreditdaten |
| Geräteaktivität | Beobachtung von Aktivitäten, teilweise auch außerhalb der Arbeit für Outlier |
| Datenübermittlung | Weitergabe an LinkedIn, TikTok, Facebook und Analysedienste, teilweise im Abstand weniger Sekunden |
Ob und in welchem Umfang diese Vorwürfe zutreffen, müssen nun die zuständigen Behörden prüfen. noyb argumentiert, Scale AI fehle eine ausreichende Rechtsgrundlage für die Installation und Nutzung der Tracking-Software. Außerdem soll die umfassende Erfassung gegen den Grundsatz der Datenminimierung verstoßen.
„Ein derart ständiges und weitreichendes Tracking während der Arbeit widerspricht allen vernünftigen Erwartungen. Warum sollten LinkedIn oder Facebook wissen, an welchen Aufgaben gearbeitet wird?“
Auch das Auskunftsrecht ist Teil der Beschwerden
Die DSGVO gilt seit 2018 und verpflichtet Unternehmen unter anderem dazu, nur die für einen festgelegten Zweck erforderlichen Daten zu verarbeiten. Betroffene haben zudem das Recht zu erfahren, welche personenbezogenen Informationen über sie gespeichert wurden.
Scale AI soll entsprechende Auskunftsersuchen nach Darstellung von noyb ignoriert haben. Auch dieser Punkt ist Gegenstand der Beschwerden. Welche Auflagen oder Sanktionen daraus entstehen könnten, ist bislang offen.
Scale AI weist die Anschuldigungen zurück. Das Unternehmen erklärt, die Praktiken seien gegenüber den Mitwirkenden offengelegt und setzten deren Einwilligung voraus.
„Die Behauptungen sind unbegründet und unzutreffend. Die Praktiken von Outlier werden den Mitwirkenden offengelegt und erfordern ihre Zustimmung. Standardwerkzeuge dienen dazu, Identitäten zu prüfen, Betrug zu verhindern, vertrauliche Projektdaten zu schützen und korrekte Zahlungen sicherzustellen.“
Risiko in der KI-Lieferkette
Für Unternehmen im DACH-Raum ist der Fall relevant, weil eine der Beschwerden in Österreich eingereicht wurde. Ob und wie viele Auftragnehmer aus Deutschland oder der Schweiz auf Outlier arbeiten, ist nicht bekannt.
Die größere Frage betrifft die Kontrolle über ausgelagerte KI-Prozesse. Wer Modelle großer US-Anbieter nutzt, bezieht nicht nur eine API oder eine Cloud-Leistung. Im Hintergrund können weitere Unternehmen an Datenauswahl, Annotation, Qualitätskontrolle und Sicherheit beteiligt sein.
Diese Dienstleisterkette erschwert die Compliance-Prüfung. Vertragspartner, Datenflüsse und technische Kontrollmaßnahmen sind für Kunden häufig nur eingeschränkt sichtbar. Der Fall ergänzt damit die Debatte über die hohen Kosten und praktischen Hürden einer europäischen Cloud-Souveränität.
Bislang ist nicht bekannt, ob OpenAI, Google oder andere Scale-Kunden vertragliche Konsequenzen prüfen. Aus den Beschwerden lässt sich daher keine konkrete Verantwortlichkeit dieser Kunden ableiten.
Mehr Kontrolle durch offene und lokale Systeme
Open-Source-Modelle und lokal betriebene Infrastruktur beseitigen Datenschutzrisiken nicht automatisch. Sie können jedoch die Zahl externer Beteiligter reduzieren und Datenflüsse nachvollziehbarer machen. Unternehmen behalten dadurch mehr Kontrolle über Protokolle, Zugriffsrechte und Aufbewahrungsfristen.
Dass Open-Weight-Modelle für viele Aufgaben wirtschaftlich konkurrenzfähig sein können, zeigt auch die Einschätzung von IBM zur Leistungsfähigkeit offener KI-Modelle. Für besonders sensible Umgebungen kommen zusätzlich abgeschottete Betriebsformen infrage, wie sie etwa bei den Air-Gap-Plänen von OpenDesk vorgesehen sind.
Dem stehen eigener Betriebsaufwand, Sicherheitsupdates und der Bedarf an internem Fachwissen gegenüber. Dennoch kann eine kontrollierte Architektur langfristig kalkulierbarer sein als eine proprietäre Dienstleisterkette, deren Datenerfassung erst durch Beschwerden sichtbar wird.
Was Unternehmen jetzt prüfen sollten
- Welche Unterauftragnehmer an Training, Annotation und Qualitätskontrolle beteiligt sind
- Welche personenbezogenen Daten für Identitätsprüfung und Betrugsprävention verarbeitet werden
- Ob Tracking auch außerhalb der eigentlichen Arbeitsplattform stattfindet
- An welche Analyse-, Werbe- oder Plattformanbieter Daten übermittelt werden
- Wie Auskunfts-, Lösch- und Widerspruchsrechte praktisch umgesetzt werden
- Ob lokale oder selbst betriebene Modelle für sensible Prozesse eine realistische Alternative darstellen